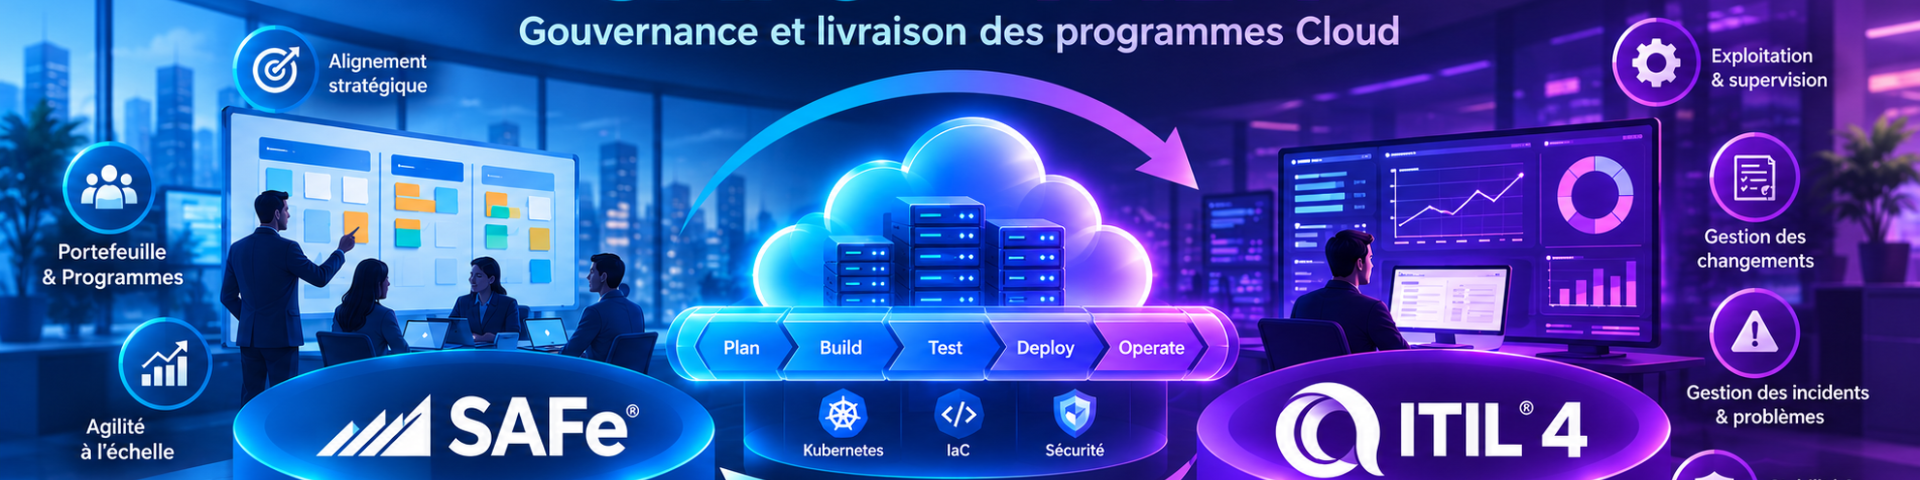
Pourquoi les programmes cloud s'enlisent au niveau de la gouvernance
La plupart des grands programmes cloud n'échouent pas sur la technique. La landing zone est construite, les clusters Kubernetes tournent, les modules Terraform sont publiés. Ce qui casse, c'est le tissu conjonctif : qui décide de ce qui est financé, qui autorise une mise en production, comment on traite un incident quand la moitié du parc est gérée par une équipe plateforme et l'autre moitié par une production historique, et comment on restitue tout cela au comité de pilotage sans tomber dans le théâtre PowerPoint mensuel.
Deux référentiels dominent le sujet dans les grandes entreprises françaises et européennes : SAFe côté delivery (portefeuille, Agile Release Trains, PI Planning) et ITIL 4 côté service (change enablement, gestion des incidents, des problèmes, des configurations). Ils sont généralement portés par des entités différentes, parlent des langues différentes, et sont souvent opposés l'un à l'autre — « l'agilité contre le contrôle ». Ce cadrage est faux, et coûteux. Utilisés délibérément, SAFe répond à que construire et dans quel ordre, ITIL répond à comment l'exploiter sans risque et se rétablir quand ça casse. Un programme cloud a besoin des deux réponses.
Deux grammaires, une seule chaîne de valeur
La première étape concrète consiste à cesser de traiter les deux référentiels comme des modèles opérationnels concurrents et à les projeter sur une même chaîne de valeur. SAFe décrit le flux de la stratégie au déploiement ; ITIL 4 décrit le Service Value System, de la demande à la valeur, en incluant les pratiques d'exploitation. Ils se recouvrent au milieu — et c'est précisément là que naissent les conflits de gouvernance.
| Question de gouvernance | Artefact SAFe | Pratique ITIL 4 | Porteur recommandé |
|---|---|---|---|
| Financement et priorisation | Lean Portfolio Management, Epics, guardrails | Gestion du portefeuille et de la demande | Fonction LPM, avec apport FinOps |
| Engagement de périmètre | PI Planning, PI Objectives | Service level management | ART / product management |
| Autorisation de mise en production | Continuous Delivery Pipeline, DoD | Change enablement | Équipe plateforme + change authority |
| Vérité sur les actifs et environnements | — | Service configuration management (CMDB) | Plateforme, alimentée depuis l'IaC |
| Réponse aux incidents | — (astreinte DevOps) | Incident / major incident management | Astreinte produit, coordination ITSM |
| Élimination des récurrences | Inspect & Adapt, backlog d'amélioration | Problem management | Partagé, backlog unique |
Le schéma qui fonctionne : les pratiques ITIL définissent les objectifs de contrôle, la cadence SAFe définit où vit le travail qui permet de les satisfaire. Le problem management n'obtient pas un backlog parallèle : ses conclusions deviennent des enabler stories dans le backlog d'équipe, visibles en PI Planning, en concurrence pour la capacité comme le reste. Si un problem record n'arrive pas à gagner sa place, c'est une discussion de priorisation, pas une défaillance de processus.
Le change enablement, point de rupture ou de réussite
Rien ne tue plus vite la vélocité d'un programme cloud qu'un CAB hebdomadaire passant en revue des plans Terraform. ITIL 4 s'est explicitement éloigné du Change Advisory Board monolithique au profit d'une change authority proportionnée au type de changement, avec trois catégories : standard (pré-autorisé, risque faible, procédure documentée), normal (évalué puis autorisé) et urgent.
Tout l'objectif de la conception de gouvernance d'un programme cloud doit être de faire basculer le maximum de trafic de déploiement dans la catégorie changement standard, le pipeline jouant lui-même le rôle d'autorité de changement. C'est une lecture légitime d'ITIL 4, pas un contournement — mais elle ne tient que si le pipeline applique réellement les contrôles qu'un relecteur humain aurait appliqués.
Concrètement, un changement est éligible à la voie standard lorsqu'il peut démontrer : une pull request approuvée et revue, une évaluation policy-as-code réussie, des tests automatisés, un rayon d'impact connu et une stratégie de déploiement réversible. On encode cela en politique, pas dans une page Confluence.
package change.standard

# Un déploiement qualifie comme changement standard pré-autorisé
default eligible := false

eligible if {
  input.pr.approvals >= 1
  input.pr.author != input.pr.approvers[_]
  input.tests.unit == "passed"
  input.policy.scan.critical == 0
  input.deployment.strategy in {"canary", "blue-green", "rolling"}
  input.target.criticality != "tier-0"
  not touche_reseau_partage
}

touche_reseau_partage if {
  some r in input.plan.resource_changes
  startswith(r.type, "aws_transit_gateway")
}

# Tout le reste retombe en changement normal avec autorité humaine
requires_cab if { not eligible }
Le pipeline écrit ensuite automatiquement l'enregistrement de changement — a posteriori pour les changements standards, avant déploiement pour les normaux. L'outil ITSM cesse d'être une barrière que les ingénieurs contournent pour devenir un registre que les auditeurs peuvent lire.
- name: Enregistrement du change record
  if: always()
  run: |
    curl -sS -X POST "$SNOW_URL/api/now/table/change_request" \
      -u "$SNOW_USER:$SNOW_PASS" \
      -H 'Content-Type: application/json' \
      -d "{
        \"type\": \"standard\",
        \"short_description\": \"Déploiement ${SERVICE} ${GIT_SHA:0:7} en prod\",
        \"cmdb_ci\": \"${CI_SYS_ID}\",
        \"assignment_group\": \"${ART_NAME}\",
        \"implementation_plan\": \"${CI_PIPELINE_URL}\",
        \"backout_plan\": \"argocd app rollback ${SERVICE}\",
        \"close_code\": \"${JOB_STATUS}\"
      }"
Le problème de la CMDB, et comment l'IaC le résout
La gestion des configurations est la pratique ITIL qui s'effondre le plus systématiquement dans le cloud. Une CMDB maintenue à la main pour décrire une infrastructure élastique et éphémère est fausse en quelques heures. Or sans elle, la gestion des incidents n'a pas d'analyse d'impact, le change enablement n'a pas d'évaluation de risque, et le FinOps n'a pas d'allocation de coûts.
La correction consiste à inverser le flux : la CMDB doit être consommatrice de la vérité d'infrastructure, pas sa source. L'état Terraform, les API d'inventaire des fournisseurs cloud et les ressources Kubernetes sont le système de référence ; un job de réconciliation les projette en configuration items. Le tagging obligatoire devient alors un contrôle de gouvernance qui a du mordant, car ce sont les tags qui portent les relations service, ART, criticité et centre de coûts, à la fois vers la CMDB et vers le modèle d'allocation FinOps.
variable "governance_tags" {
  type = object({
    service_id   = string  # identifiant du CI dans la CMDB
    art          = string  # Agile Release Train propriétaire
    criticality  = string  # tier-0 | tier-1 | tier-2
    cost_center  = string
    data_class   = string  # public | interne | confidentiel | réglementé
  })
}

# Contrôlé au moment du plan, pas découvert au moment de l'audit
Un contrat de tagging unique sert ainsi trois fonctions de gouvernance simultanément : analyse d'impact des incidents, scoring de risque des changements, et showback financier. C'est le type de levier qui mérite d'être défendu dès les premiers incréments d'un programme.
Financement : les guardrails LPM face à la réalité FinOps
Le Lean Portfolio Management de SAFe remplace le financement par projet par le financement de chaînes de valeur sous guardrails. Dans le cloud, ces garde-fous doivent inclure la consommation, pas seulement les effectifs. Un ART financé pour douze ingénieurs dont la dépense cloud double sans que personne ne le voie n'opère pas dans ses guardrails, quoi qu'en dise le burn-down.
En pratique : le coût cloud devient un élément de premier plan de la revue trimestrielle de portefeuille et de la cadence de l'ART ; les unit economics (coût par transaction, par tenant, par inférence de modèle) sont présentés à côté des PI Objectives ; la détection d'anomalie est routée vers l'équipe, pas vers une boîte mail FinOps centrale ; le travail d'optimisation dépassant un seuil entre au backlog comme enabler epic avec un business case. L'erreur classique est de créer une équipe FinOps centrale qui produit des rapports sur lesquels personne n'agit, parce que les équipes qui génèrent la dépense n'ont aucune responsabilité budgétaire.
Des métriques qui tiennent devant les deux publics
Les directions veulent de l'assurance, les ingénieurs veulent du signal. Un tableau de bord de gouvernance combinant métriques de flux SAFe, métriques de service ITIL et métriques DORA donne les deux, à condition de rester court.
| Dimension | Métrique | Intérêt pour la gouvernance |
|---|---|---|
| Flux | Flow time, flow load par ART | Détecte la surcharge avant le dérapage des PI Objectives |
| Delivery | Fréquence de déploiement, lead time | Montre si le change enablement freine |
| Stabilité | Change failure rate, MTTR | Preuve que la voie standard est sûre |
| Service | Atteinte des SLO, incidents majeurs | Relie les choix de delivery à l'expérience client |
| Économie | Coût par unité de valeur, taux de gaspillage | Rend les guardrails de portefeuille crédibles |
| Conformité | % de déploiements en voie standard, violations de politique | Démontre que le modèle de contrôle tient à l'échelle |
Une métrique mérite une attention particulière : la part des changements de production passant par la voie standard pré-autorisée. Si elle monte sans dégrader le change failure rate, l'intégration fonctionne. Si elle monte en dégradant les échecs, la politique est trop permissive. Si elle reste basse, l'organisation a adopté le vocabulaire SAFe par-dessus une bureaucratie ITIL inchangée.
Les anti-patterns à nommer
Trois modes d'échec reviennent. Le premier est la gouvernance en double pile : un processus ITSM pour le legacy, un processus informel pour le cloud, sans passerelle. L'audit finit par imposer la réconciliation, généralement au pire moment. Le deuxième est SAFe comme couche de reporting : le PI Planning produit un plan que des chefs de projet suivent ensuite dans un autre outil, les processus de changement restant intacts — toute la cérémonie, aucun flux. Le troisième est l'équipe plateforme transformée en file de tickets : chaque demande d'environnement, de rôle IAM ou d'enregistrement DNS passe par un service desk, ce qui garantit que la plateforme devient la contrainte de tous les ARTs.
La réponse aux trois est la même : traiter la plateforme interne comme un produit doté d'une interface (API en self-service, golden paths, catalogue de services) et encoder la gouvernance dans cette interface. Une gouvernance consommée comme une voie pavée est adoptée ; une gouvernance consommée comme une barrière est contournée.
Un séquencement pragmatique
N'essayez pas de refondre le modèle opérationnel d'un coup. Au premier trimestre, alignez la cartographie de la chaîne de valeur et le vocabulaire partagé, et définissez les services tier-0. Au deuxième, construisez la voie de changement standard pour un ART et un service non critique, avec policy-as-code et change records automatisés. Au troisième, branchez la CMDB sur l'IaC et introduisez le contrat de tagging. Ensuite seulement, étendez aux services tier-1 et au reste du portefeuille, et intégrez les guardrails FinOps à la cadence LPM.
L'état cible n'a rien de spectaculaire et il est redoutablement efficace : des ingénieurs qui déploient plusieurs fois par jour sans ouvrir de ticket, des auditeurs qui disposent d'un registre de changements complet et interrogeable, et un comité de portefeuille capable de voir où partent réellement l'argent et la capacité. SAFe et ITIL n'ont pas besoin d'être réconciliés sur le plan philosophique. Ils ont besoin d'être câblés dans le même pipeline.