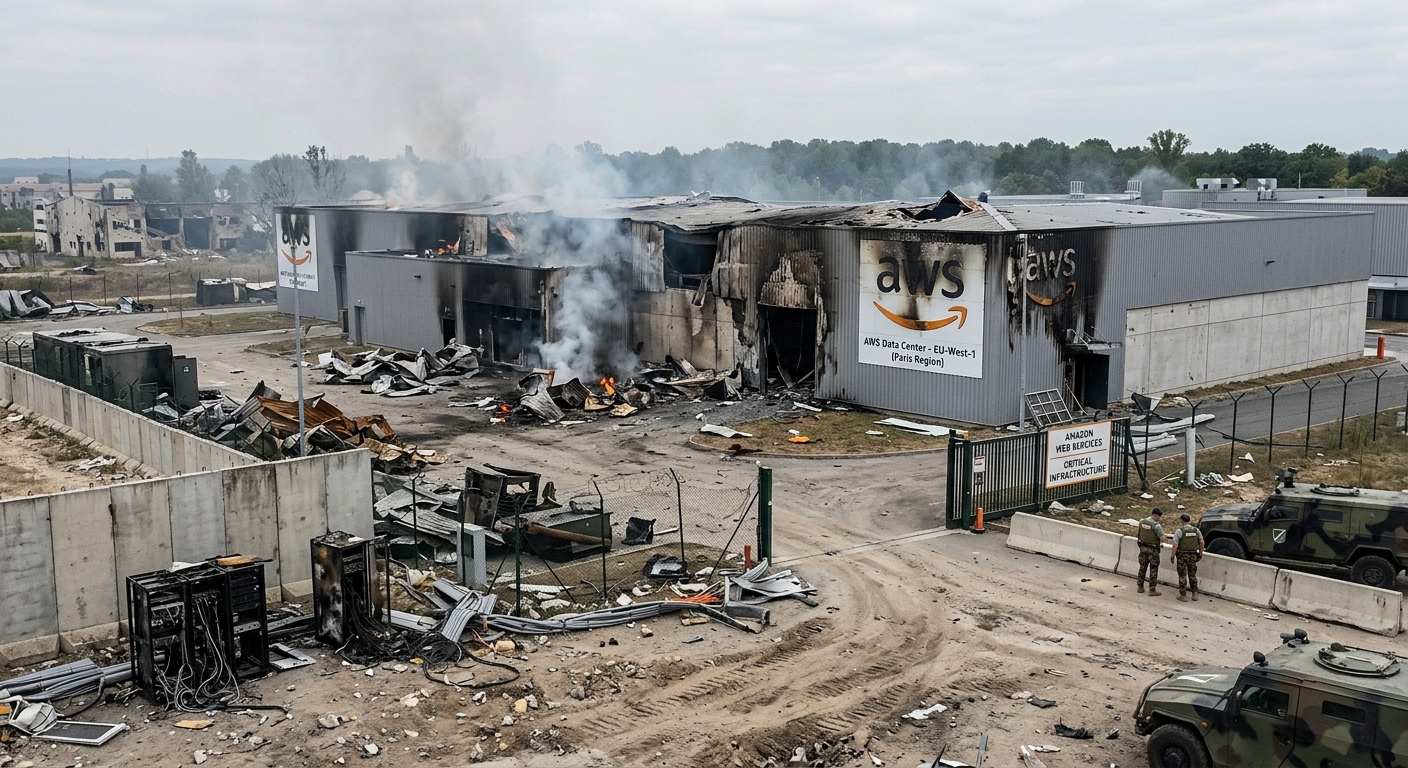
Ce qui s'est passé
À la mi-septembre 2026, AWS a confirmé aux clients concernés qu'un incident survenu dans sa région de Bahreïn (me-south-1) avait entraîné la perte définitive et irrécupérable de certaines données clients. Pas une dégradation de performance. Pas une indisponibilité prolongée. Des données qui n'existent plus et qu'AWS ne peut pas restaurer.
Les détails restent à ce stade circonscrits aux clients touchés, et il serait irresponsable de spéculer sur la cause racine, le périmètre exact ou les types de ressources impliqués avant la publication d'un post-mortem complet. Ce qui compte pour tous les autres est bien plus actionnable : le mode de défaillance que la plupart des architectures évacuent silencieusement — le fournisseur cloud qui perd vos données — n'est pas théorique.
Si votre première réaction a été « impossible, S3 offre onze neufs de durabilité », cet article est écrit pour vous.
La durabilité est un modèle statistique, pas une garantie
Les fameux chiffres de durabilité publiés pour le stockage objet décrivent une probabilité annuelle attendue de perte d'un objet, sous un modèle de réplication donné et dans un périmètre donné. Trois contresens reviennent systématiquement :
- Le périmètre. Les engagements de durabilité portent sur la redondance interne d'un service — typiquement plusieurs zones de disponibilité au sein d'une seule région. Ils ne disent rien des défaillances corrélées touchant une région entière, des bugs de plan de contrôle, ou de la règle de cycle de vie que vous avez écrite vous-même.
- La classe de panne. Ces modèles couvrent la défaillance matérielle. Ils ne couvrent ni le défaut logiciel, ni l'erreur humaine (la leur ou la vôtre), ni la suppression malveillante, ni le ransomware, ni la fermeture de compte, ni la suppression d'une clé KMS.
- Le recours. Le contrat client et les SLA d'AWS prévoient des avoirs de service pour l'indisponibilité. Ce n'est pas une assurance perte de données. Un avoir ne reconstruit pas votre base de production.
La durabilité est une donnée d'entrée d'ingénierie. Ce n'est pas une stratégie de sauvegarde.
Le modèle de responsabilité partagée, lu au pied de la lettre
AWS est responsable de la résilience du cloud. Vous êtes responsable de la résilience dans le cloud — ce qui inclut explicitement votre stratégie de sauvegarde et de restauration, votre topologie de réplication et votre capacité effective à restaurer. Cette phrase figure dans tous les livres blancs AWS. C'est aussi celle qu'on saute le plus volontiers pendant une migration sous contrainte de délai.
Concrètement, la question à poser à chaque composant avec état de votre plateforme est : si cette région disparaissait définitivement demain, que me resterait-il, où est-ce stocké, et combien de temps pour resservir du trafic ? Si la réponse nécessite une réunion, vous n'avez pas de PRA : vous avez une intention.
Connaître ses domaines de panne
La plupart des SPOF silencieux dans les architectures AWS proviennent de ressources dont le domaine de panne par défaut est plus étroit que ce que les équipes supposent.
| Ressource | Domaine de panne par défaut | Ce qui vous protège réellement |
|---|---|---|
| Volume EBS | Une seule AZ | Snapshots + copie de snapshot cross-région |
| Instance store EC2 | Un seul hôte — perte à l'arrêt | N'y stocker aucun état |
| RDS / Aurora mono-AZ | Une seule AZ | Multi-AZ + sauvegardes automatiques répliquées cross-région |
| S3 Standard | Multi-AZ, région unique | Versioning + Object Lock + réplication cross-région |
| S3 One Zone-IA | Une seule AZ | Réplication, ou tout simplement ne pas l'utiliser pour ce qui compte |
| EFS One Zone | Une seule AZ | AWS Backup avec copie cross-région |
| DynamoDB | Multi-AZ, région unique | Global Tables + PITR + sauvegardes à la demande |
| Images ECR | Région unique | Règles de réplication cross-région |
| Clé KMS | Région unique | Multi-Region Keys — sinon vos copies sont illisibles |
Cette dernière ligne mérite qu'on insiste. Un snapshot chiffré parfaitement répliqué dans une seconde région ne vaut rien si la seule clé capable de le déchiffrer vivait dans la région perdue. Les clés KMS multi-régions, ou le rechiffrement au moment de la copie, font partie du chemin de restauration — ce n'est pas un détail.
Construire un chemin de restauration qui ne fait pas confiance au fournisseur
La règle classique du 3-2-1 se traduit très bien dans le cloud : trois copies des données, sur deux technologies ou domaines de panne distincts, dont au moins une hors du rayon d'explosion principal. En pratique, trois niveaux progressifs :
Niveau 1 — copies cross-région au sein d'AWS. Peu coûteux, automatisable, couvre la perte régionale. Insuffisant contre la compromission de compte ou une mauvaise configuration appliquée à toute l'organisation.
Niveau 2 — un compte AWS distinct aux identifiants isolés. Des coffres de sauvegarde dans un compte dédié, alimentés par un rôle de service, avec Vault Lock en mode conformité pour qu'aucun administrateur — pas même le vôtre — ne puisse raccourcir la rétention. C'est ce qui transforme une sauvegarde en sauvegarde immuable.
Niveau 3 — une copie hors d'AWS. Pour vos jeux de données réellement irremplaçables (grand livre de facturation, référentiel client, archives réglementaires), un export vers un second fournisseur ou vers du stockage on-premises. Coûteux, lent, et seul dispositif qui survit à une catastrophe au niveau du fournisseur ou à un litige commercial qui verrouille votre compte.
Voici la base du niveau 2 en Terraform, avec copie cross-région et Vault Lock :
resource "aws_backup_vault" "primary" {
  name        = "prod-me-south-1"
  kms_key_arn = aws_kms_key.backup_mrk.arn
}

resource "aws_backup_vault_lock_configuration" "primary" {
  backup_vault_name   = aws_backup_vault.primary.name
  changeable_for_days = 3      # délai de réflexion avant verrouillage définitif
  min_retention_days  = 30
  max_retention_days  = 365
}

resource "aws_backup_plan" "prod" {
  name = "prod-quotidien-copie-pra"

  rule {
    rule_name         = "quotidien-0200"
    target_vault_name = aws_backup_vault.primary.name
    schedule          = "cron(0 2 * * ? *)"
    start_window      = 60
    completion_window = 360

    lifecycle {
      delete_after = 35
    }

    copy_action {
      destination_vault_arn = aws_backup_vault.dr.arn  # provider aliasé, seconde région
      lifecycle {
        cold_storage_after = 30
        delete_after       = 365
      }
    }
  }
}

resource "aws_backup_selection" "tagged" {
  name         = "tag-backup-true"
  plan_id      = aws_backup_plan.prod.id
  iam_role_arn = aws_iam_role.backup.arn

  selection_tag {
    type  = "STRINGEQUALS"
    key   = "Backup"
    value = "true"
  }
}
La sélection par tag n'est pas un détail cosmétique : elle fait de la couverture de sauvegarde une propriété imposée par la politique (refus de création de ressource sans tag Backup) plutôt qu'un geste dont une équipe doit se souvenir.
Le point inconfortable : résidence des données contre résilience
Bahreïn est une région choisie très majoritairement pour des raisons réglementaires — exigences de résidence des données dans le Golfe, règles du secteur financier, obligations du secteur public. D'où une tension réelle : la réponse évidente à une perte régionale est « copier ailleurs », et la réponse évidente à la résidence est « surtout pas ».
Des chemins praticables existent, mais ils exigent tous une décision explicite plutôt qu'un réglage par défaut :
- Rattacher les obligations de résidence à des classes de données, pas à la plateforme entière. Très souvent, seul un sous-ensemble de données personnelles ou réglementées doit rester dans le pays. Agrégats, métadonnées opérationnelles, artefacts et état d'infrastructure peuvent fréquemment être copiés ailleurs.
- Utiliser une seconde région dans le même bloc juridictionnel lorsque le régulateur l'accepte — c'est exactement l'argument en faveur de topologies multi-régions au Moyen-Orient plutôt que de déploiements mono-région.
- Conserver une copie locale hors AWS. Un acteur local ou votre propre datacentre pour le périmètre réglementé. C'est l'argument que les équipes européennes formulent sur la souveraineté : un fournisseur unique, aussi grand soit-il, reste un point de défaillance unique, techniquement et contractuellement.
- Chiffrer avec des clés dont vous gardez le contrôle, pour qu'une copie hébergée ailleurs reste défendable juridiquement comme « non lisible par l'hébergeur ».
Le pire résultat est celui qu'on obtient par défaut : la résidence invoquée comme prétexte pour n'avoir aucune seconde copie.
Une sauvegarde non restaurée est une hypothèse
Tous les retours d'expérience sérieux aboutissent à la même conclusion : les sauvegardes existaient, et la restauration n'a pas fonctionné. Snapshots d'une base dont la version de moteur n'est plus disponible. Copie chiffrée sans sa clé. Restauration de 4 To qui prend onze heures alors que le RTO annoncé était de deux. Runbook citant une personne partie depuis dix-huit mois.
Faites de la restauration une opération planifiée, mesurée et ennuyeuse :
- Game day trimestriel : restaurer le jeu de données le plus critique dans un compte isolé, depuis la région de secours, sans aucun accès à la région primaire. Mesurer le temps réel jusqu'à la première requête réussie.
- Automatiser une restauration partielle hebdomadaire en CI — une table, un volume — avec alerte en cas d'échec. Un job de sauvegarde en succès prouve le chemin d'écriture, pas le chemin de lecture.
- Consigner les RTO et RPO mesurés, pas déclarés, et les afficher à côté de l'attente métier. L'écart constitue votre feuille de route.
- Garder l'IaC et les images de conteneurs reproductibles hors de la région primaire. Récupérer les données ne sert à rien si vous ne pouvez pas recréer la plateforme qui les sert.
Ce qu'il faut faire cette semaine
Aucun programme de douze mois n'est nécessaire pour réduire significativement ce risque. Par ordre de rapport effort/valeur :
- Inventorier chaque ressource avec état et son domaine de panne. Une requête par tags et quelques règles AWS Config font remonter les surprises mono-AZ en une après-midi.
- Activer le versioning S3 partout, et Object Lock sur les buckets qui comptent. Activer le PITR sur les tables DynamoDB.
- Créer un compte de sauvegarde dédié, y déplacer les coffres, appliquer Vault Lock. Retirer aux rôles de production le droit de supprimer des points de restauration.
- Ajouter des
copy_actioncross-région aux plans de sauvegarde, et vérifier que les clés KMS sont multi-régions ou que les copies sont rechiffrées. - Planifier un exercice de restauration avec une date, un responsable et un résultat mesuré.
L'incident de Bahreïn finira par être expliqué, corrigé et documenté. La leçon durable est indépendante de la cause racine : les fournisseurs cloud sont extraordinairement fiables, et une fiabilité extraordinaire n'est pas l'infaillibilité. Concevez comme si votre fournisseur perdait un jour vos données — parce que pour quelques clients, en septembre 2026, c'est exactement ce qui s'est produit.